A cena se repete em empresa de todo tamanho. O sistema trava. A recepção para. Alguém liga para o provedor. O provedor testa e responde: “o link está ok, sem perda, latência normal”. O sistema continua travando.
Os dois estão dizendo a verdade. O problema é que não estão medindo a mesma coisa. Enquanto essa conversa não muda, cada travada vira discussão — e a discussão custa mais tempo do que a própria falha.
O que o teste do provedor realmente mede
O teste padrão pergunta a um equipamento se ele está vivo e quanto tempo leva para responder. É o famoso ping. Ele manda um pacotinho de aviso, espera a resposta voltar e cronometra o percurso. Mede se o caminho existe e se a resposta chega rápido.
Isso é útil e é pouco. Um caminho pode estar perfeitamente vivo enquanto o que trafega por ele não funciona. O pacote de teste é minúsculo, viaja sozinho e não pede nada a ninguém. Ele não abre tela, não consulta banco de dados, não carrega relatório. Ele prova que a estrada existe. Não prova que a entrega chegou.
Há um detalhe que quase nunca chega ao dono da empresa: dentro dos equipamentos, esse pacote de aviso costuma ser tratado à parte do trânsito comum. Quando a rede enche, quem fica na fila é o trabalho de verdade — a tela do sistema, o arquivo, a chamada de voz. O aviso continua indo e voltando depressa, porque é curto e barato de responder. O teste passa. A fila, não.
É como ligar para um restaurante e alguém atender no primeiro toque. O telefone funciona, a linha está ótima, o atendimento é imediato. Isso não diz absolutamente nada sobre quanto tempo o seu prato vai demorar.
O ping é o telefone tocando. A aplicação é a cozinha. E ninguém almoça telefone.
As cinco coisas que estão boas no teste e ruins na prática
1. Latência média boa, variação alta. A média esconde. Um link com latência média de 20 ms que oscila entre 5 e 300 ms passa em qualquer teste rápido e derruba qualquer sistema que conversa muito com o servidor. Essa oscilação tem nome — jitter, o vaivém do tempo de resposta — e é o que mais estraga voz, videochamada e sistema de gestão. Quem fala ouve a voz picotar. Quem digita vê o cursor congelar e digita de novo por cima.
2. Perda pequena e constante. Meio por cento de perda parece nada. Para um sistema que envia centenas de pedidos por tela, meio por cento significa retransmissão o tempo todo: o pedido perdido precisa ser enviado outra vez, e quem espera é a pessoa parada no balcão. Tem mais. Ao perceber perda, a conexão passa a mandar menos de cada vez, para não piorar o congestionamento. Ela se segura sozinha. Retransmissão é espera, e espera empilhada é a tela que não abre.
3. O link está livre; a rede interna, não. O teste do provedor mede até a porta da empresa. O que acontece do portão para dentro não aparece nele: cabo ruim, switch saturado (o aparelho que distribui a rede trabalhando no limite), uma máquina copiando arquivo grande e ocupando tudo, o Wi-Fi disputado por gente demais no mesmo canto. A estrada está livre. O engarrafamento é na portaria.
4. O caminho está ok; o servidor da aplicação, não. Se o banco de dados está lento, se falta memória, se um relatório pesado trava a base no meio do expediente, a rede continua impecável enquanto o sistema não responde. O laudo não abre, a nota não sai, o prazo corre. E o teste do link segue dizendo que está tudo certo — porque está mesmo. Só não é ali que dói.
5. Está bom agora. O teste é uma fotografia. O travamento aconteceu às 10h20, quando todo mundo abriu o sistema ao mesmo tempo. Às 15h, quando o técnico testou, estava tudo tranquilo. Ninguém mentiu: a foto é real. Ela só foi tirada na hora errada, e o problema não posa para a foto.
O que dá para conferir sozinho amanhã de manhã
Antes de contratar qualquer coisa, dá para levantar informação de graça. Isso não resolve o problema, mas encurta bastante a conversa com quem vai resolver.
- Anote a hora exata. Não “de manhã”: a hora e o minuto de cada travada. Padrão de horário é a pista mais barata que existe.
- Pergunte o que estava aberto. Qual tela, qual relatório, qual arquivo. Muitas vezes a travada tem sempre a mesma vizinha.
- Veja se trava para todos ou só para um setor. Se o financeiro trava e a recepção não, o problema mora no meio do caminho, não no link.
- Abra o mesmo sistema por outro caminho. Pelo celular, com a internet da operadora, fora da rede da empresa. Se lá funciona bem no mesmo minuto, a suspeita muda de lugar.
- Cronometre a tela que demora. Relógio na mão, do clique até a tela pronta. Anote todo dia. Uma semana disso já é histórico.
- Compare o dia cheio com o dia vazio. Se no feriado voa e na segunda-feira arrasta, a questão é disputa por espaço, não defeito de equipamento.
Nada disso exige comprar equipamento nem entender de rede. Exige caderno e teimosia.
O que medir no lugar
A pergunta certa não é “o link está de pé?”. É “a coisa que a pessoa usa está respondendo, e em quanto tempo?”
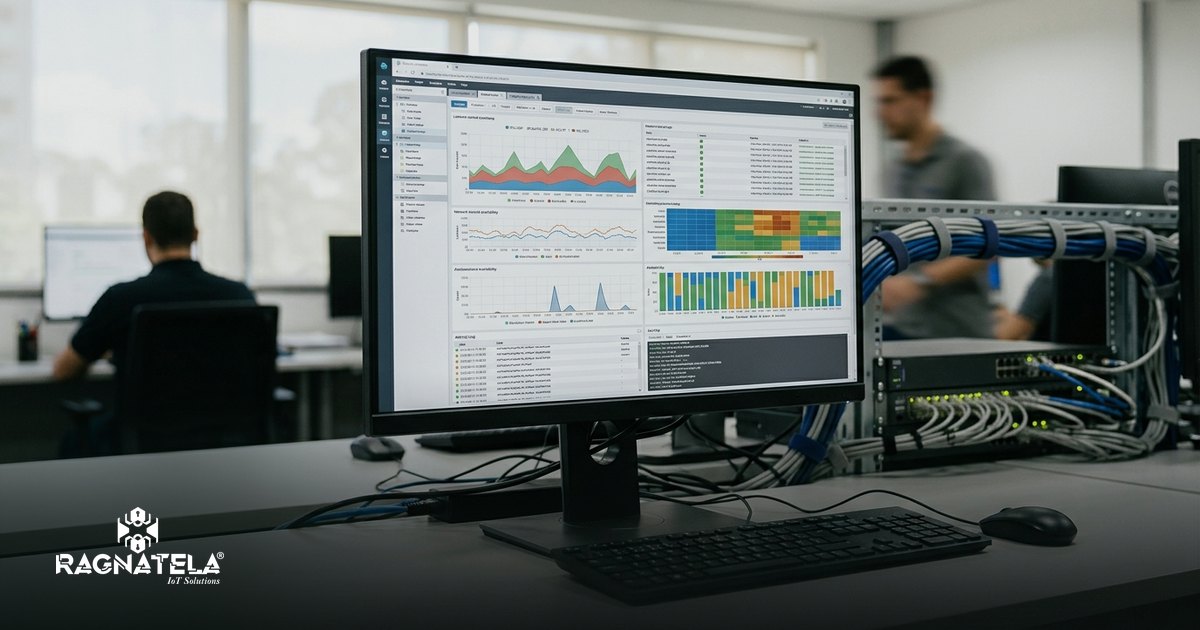
Na prática, isso significa medir de dentro da empresa, continuamente, e guardar o histórico:
- o tempo de resposta da aplicação, não o do equipamento: cronometrar a tela, não o cabo;
- a variação da latência, não só a média — é o pico que derruba, e ele não aparece na conta;
- a perda ao longo do dia inteiro, não num teste de trinta segundos;
- o uso de cada trecho da rede interna nos horários de pico, para saber qual trecho enche primeiro;
- e a saúde do servidor no mesmo instante: memória, disco e banco de dados.
Medir sem parar muda a natureza da informação. Um teste responde “agora está bom”. Uma série de medições responde “todo dia, nessa hora, piora”. A primeira frase encerra um chamado. A segunda abre uma investigação.
É esse conjunto que transforma “está lento” em “às 10h20 o tempo de resposta do sistema triplica, e nesse mesmo minuto o trecho entre o segundo andar e o servidor satura”. A segunda frase tem conserto.
Vale um comentário sobre a estrutura que existe hoje na maioria das empresas. Quase sempre foi jeitinho competente sem orçamento: alguém resolveu com o que tinha, e o negócio cresceu em cima daquilo. Isso não é falha de ninguém, é história de empresa que deu certo. Só que estrutura pensada para o tamanho de ontem costuma reclamar no tamanho de hoje.
Sem histórico, a discussão vira palavra contra palavra. Com histórico, três coisas mudam: dá para mostrar ao fornecedor onde está o problema, dá para decidir onde investir com informação em vez de achismo, e dá para perceber o padrão antes de o cliente reclamar.
A ressalva honesta
Monitorar não impede a falha. Ninguém consegue prometer que nada vai quebrar, e quem promete está vendendo outra coisa. O que o acompanhamento contínuo muda é o tempo entre a falha acontecer e alguém saber onde ela está — e é aí que mora quase todo o prejuízo de uma parada.
Pense no expediente perdido. O que custa caro não é o cabo: é a fila parada, o laudo atrasado, o retrabalho da tarde e o cliente que precisou ligar de novo. Encurtar esse intervalo reduz o prejuízo, mesmo quando a falha continua acontecendo.
Se na sua empresa a resposta para “por que travou ontem às 10h?” é um silêncio, o problema não é o link. É que ninguém está medindo.
A Ragnatela IoT Solutions trabalha com infraestrutura de TI, nuvem privada e cibersegurança, com atendimento remoto em todo o Brasil. Se você quer acompanhar o tempo de resposta daquilo que a sua equipe usa todo dia, fale com a gente.
Perguntas frequentes
Se o ping está bom, a internet está boa?
O ping mede se o caminho existe e quanto tempo leva a resposta de um equipamento. Não mede o tempo de resposta da aplicação, a variação da latência ao longo do dia nem o que acontece dentro da sua rede. É útil e é pouco.
O que é jitter, em português?
É a variação da latência. Um link com média boa que oscila muito passa em qualquer teste rápido e estraga voz, videochamada e sistema de gestão — porque o que quebra não é a demora, é a irregularidade.
Por que o técnico testa e está tudo normal?
Porque o teste é uma fotografia e o problema costuma ter hora marcada — normalmente o pico da manhã. Sem medição contínua e histórico, o momento da falha nunca coincide com o momento do teste.
Preciso de monitoramento mesmo tendo TI interna?
O monitoramento não substitui a TI interna: entrega a ela o histórico e o alerta. A diferença é parar de descobrir pela reclamação do cliente e passar a descobrir pelo dado, inclusive fora do horário.